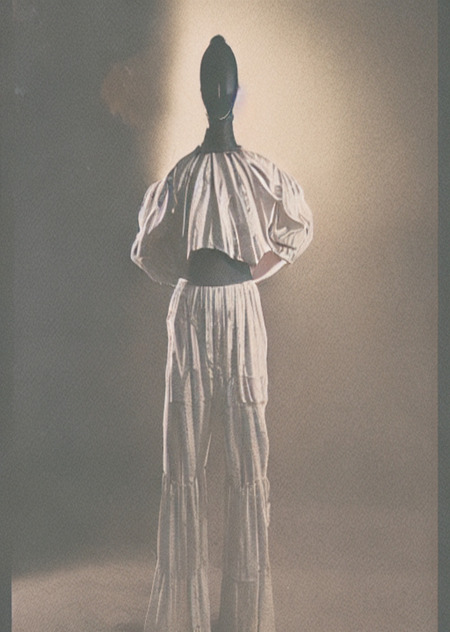
Я решила исследовать, может ли нейросеть перенять визуальный стиль фотографии и использовать его для создания новых изображений
Меня интересовало ощущение фотографии как физического объекта, старого журнального отпечатка, скана из архива или изображения, которое со временем приобрело зерно, царапины и потёртости, и именно это легло в основу моей концепции «AFTER THE SCAN»
Визуальная эстетика проекта строится на приглушённых цветах, плёночном зерне,
мягком свете, несовершенствах печати и экспериментальной fashion-съёмке
Подготовка датасета
Для обучения я использовала 21 авторскую фотографию, снятых и обработанных фотографомИзображения были отобраны по визуальному сходству и характеру обработки
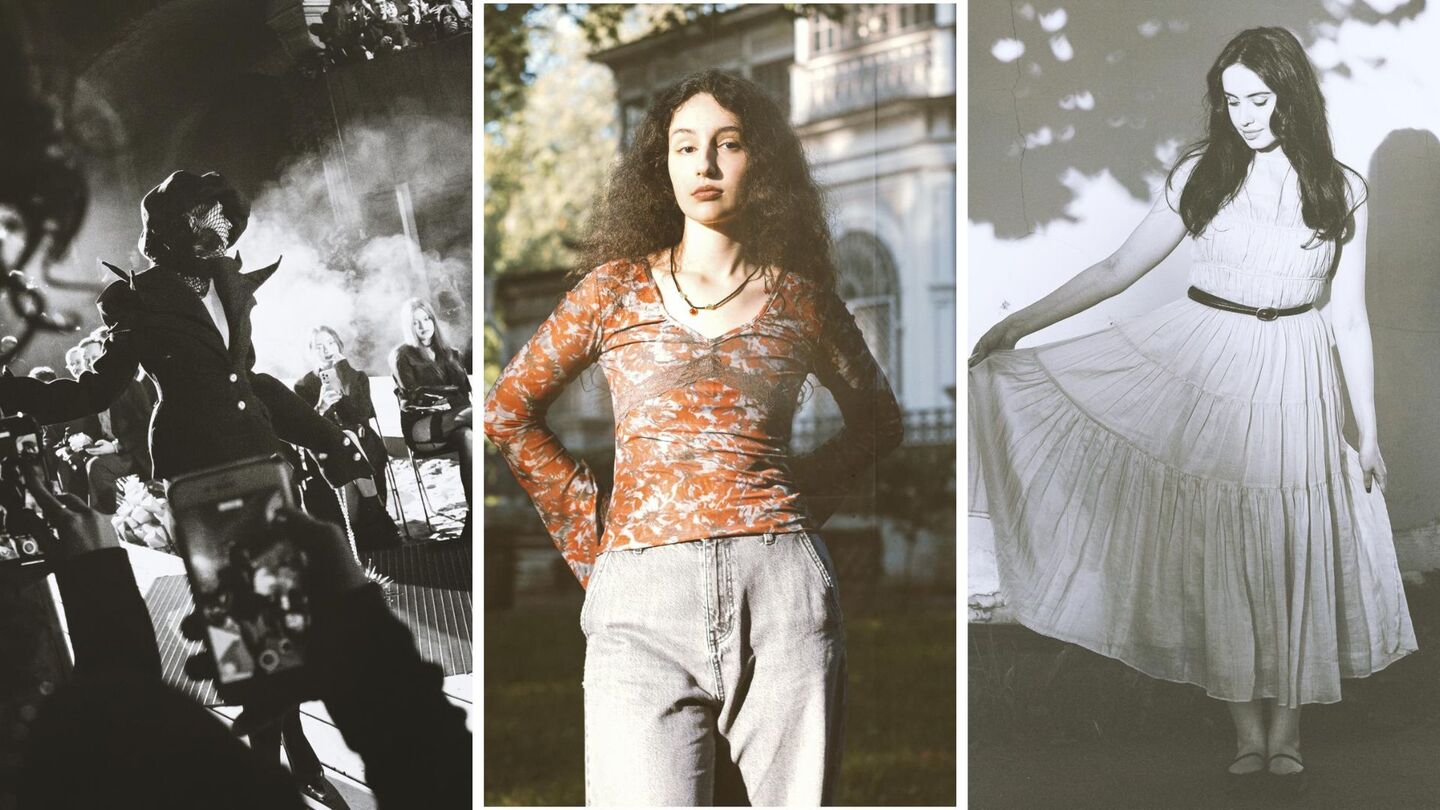
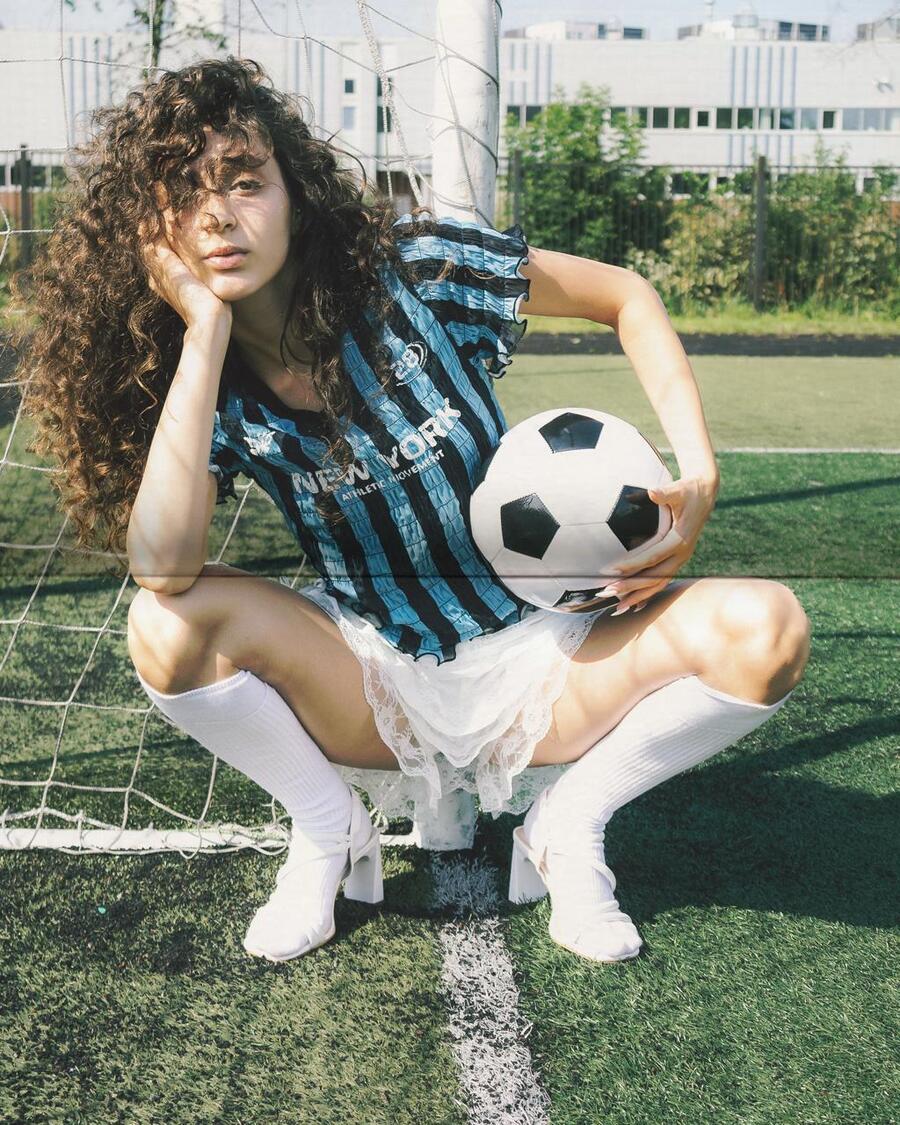
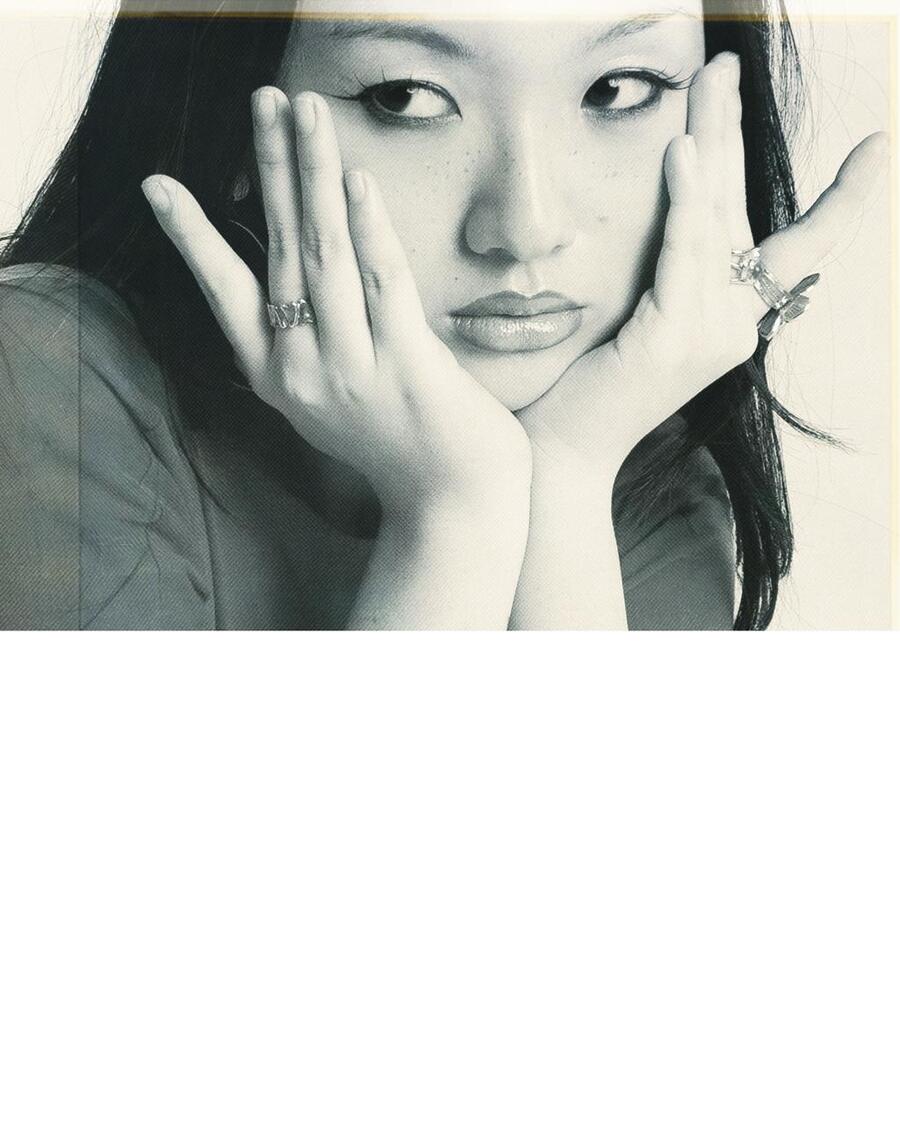
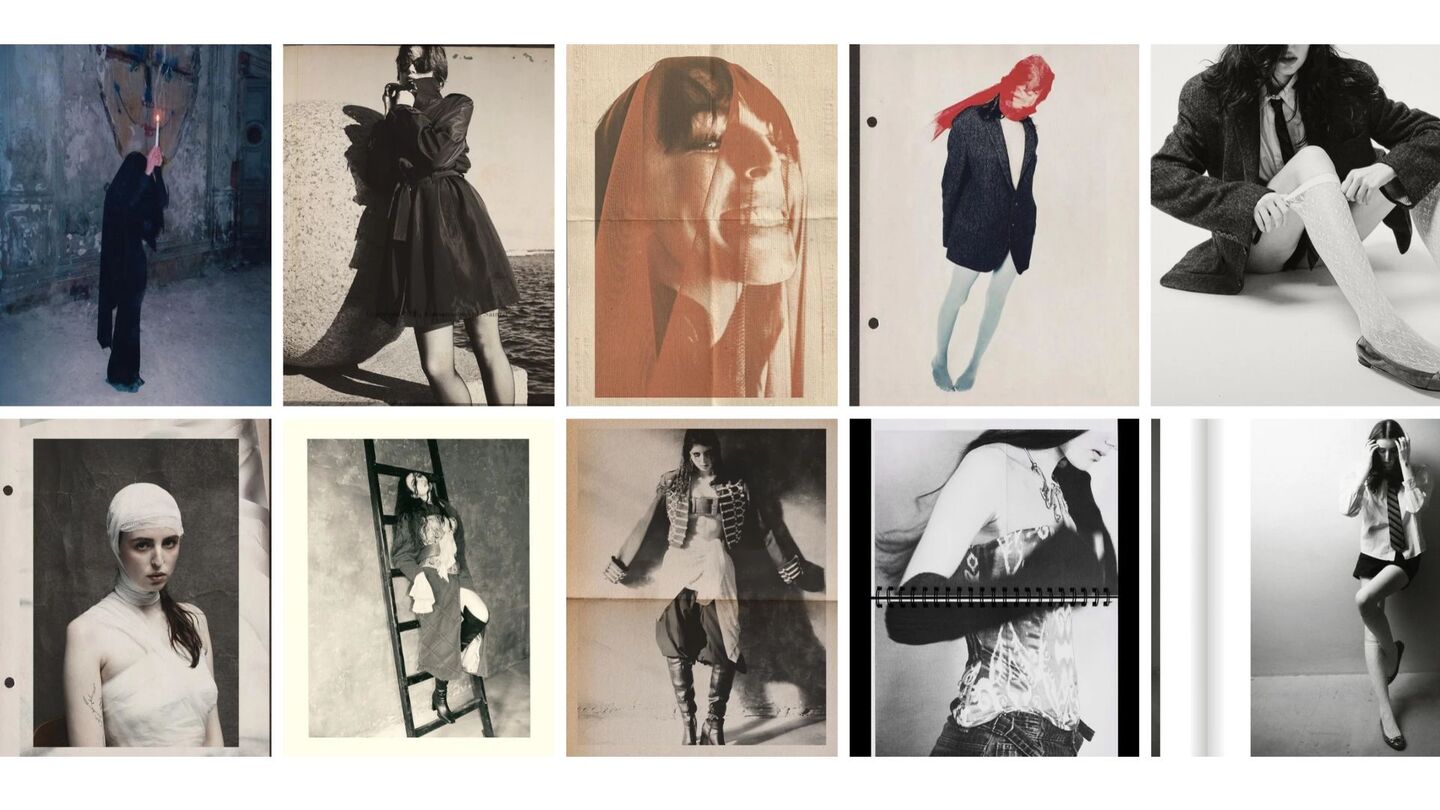
Я создала папку проекта Analog Scan Project на Google Drive и загрузила туда фотографии в папку dataset. Затем подготовила отдельную папку lora_dataset, в которой находились изображения и файл metadata.jsonl с текстовыми описаниями для обучения
В качестве описания использовался текст:
analogscanstyle, analog editorial fashion photography, experimental portrait, scanned print texture, muted colors, film grain, tactile imperfections
Токен analogscanstyle стал условным названием обучаемого стиля, которое затем использовалось в промптах для генерации
Инструменты и обучение
Для работы я использовала:— Google Drive — хранение фотографий, датасета и результатов— Google Colab — запуск кода и обучение модели на GPU Tesla T4— Hugging Face Diffusers — библиотеку для обучения и работы с генеративными моделями— GitHub — исходный код обучающего скрипта train_text_to_image_lora.py— Stable Diffusion 1.5 — базовую модель, на основе которой обучалась LoRA
Я установила необходимые библиотеки Python, подключила Google Drive к Colab и запустила обучение с помощью метода LoRA. Он позволил адаптировать существующую модель под выбранный стиль без полного переобучения
Основные параметры обучения: разрешение 512 × 512 пикселей, batch size 1, learning rate 0.0001, rank 8 и 600 шагов обучения
После завершения обучения веса модели сохранились в папке lora_output на Google Drive
Генерация изображений
После обучения я подключила полученные веса LoRA к Stable Diffusion 1.5 и начала генерировать новые изображения. Для генерации использовался токен analogscanstyle, а также описание желаемой композиции и визуальной обработки
Основной промпт:
analogscanstyle, experimental fashion editorial portrait, analog film grain, scanned photographic print, muted faded colors, dust and subtle scratches, tactile paper texture, imperfect vintage magazine scan, artistic composition, authentic editorial photography
Для второй серии я использовала более конкретное описание, чтобы сместить внимание с лица на одежду, силуэт и положение тела:
analogscanstyle, experimental fashion editorial photography, faceless human figure, cropped composition from shoulders to thighs, face completely outside the frame, focus on clothing, silhouette, posture and body language, candid editorial moment, unconventional framing, muted desaturated colors, faded analog film tones, visible 35 mm film grain, dust, fine scratches, scanned magazine print texture, subtle paper imperfections, soft natural window light, deep soft shadows, imperfect vintage color reproduction, tactile photographic surface, authentic independent fashion magazine aesthetic, understated and artistic, realistic photography, no text, no logos
Структура проекта
Файлы были организованы следующим образом:— dataset — исходный набор выбранных фотографий.
— train_images — копии изображений для подготовки обучения.
— captions — текстовые описания изображений.
— lora_dataset — итоговый датасет с metadata.jsonl.
— lora_output — обученные веса LoRA и файлы модели.
— 05_Generated — первая серия сгенерированных изображений.
— 05_Generated/series_02 — вторая серия изображений
Результаты
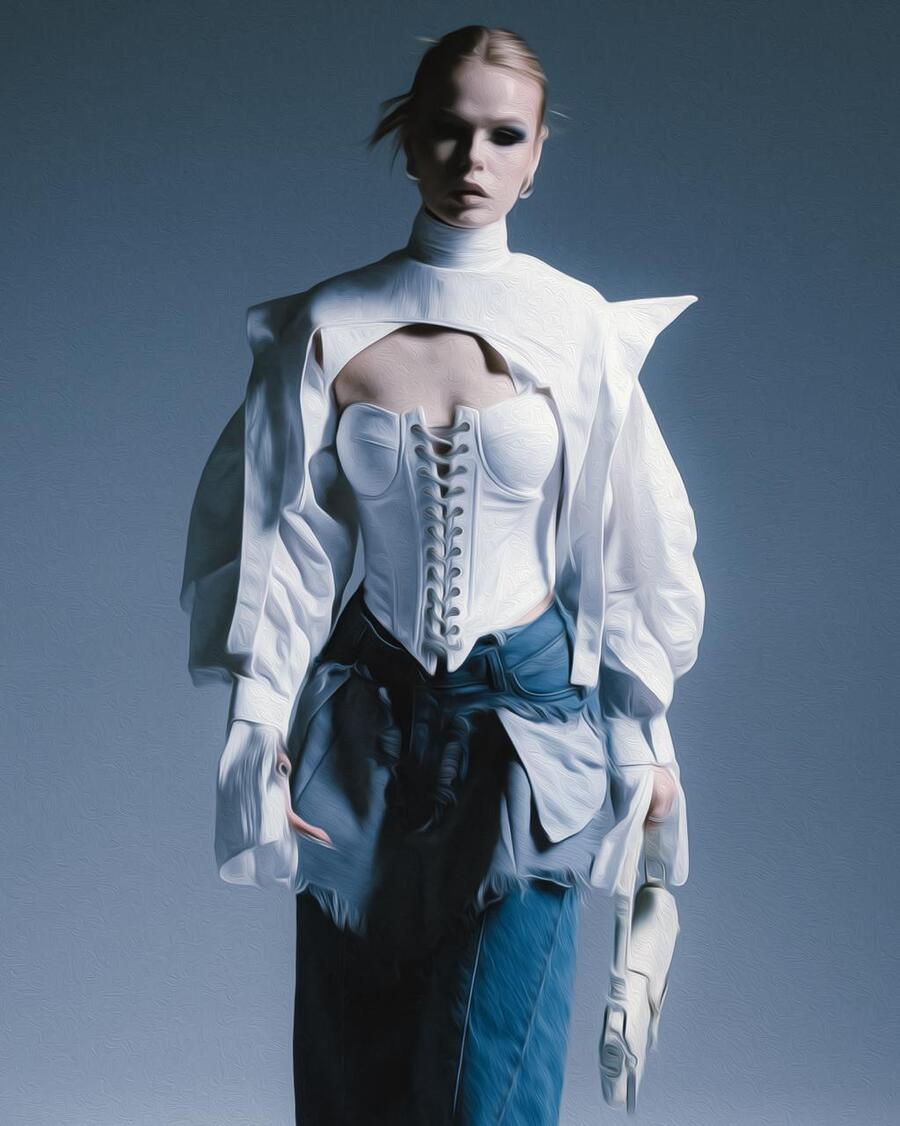
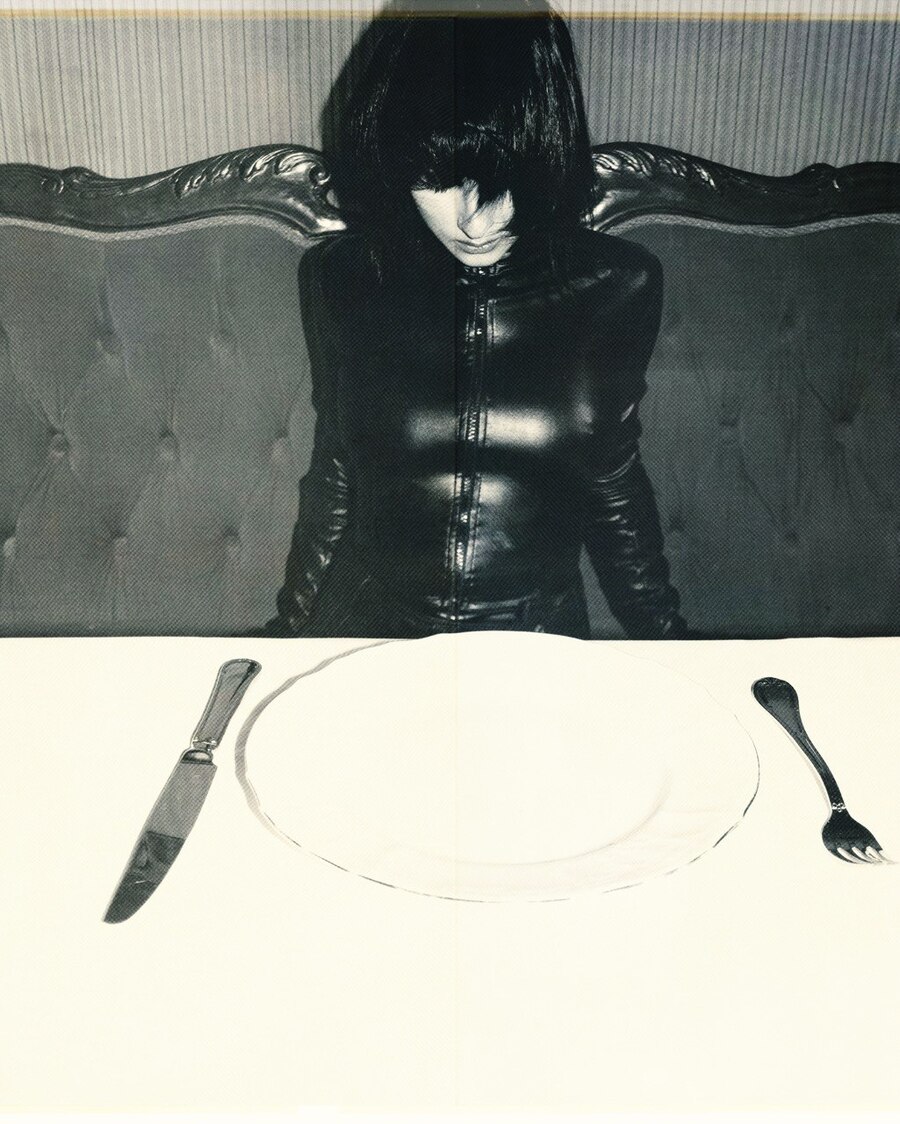
В ходе проекта мне удалось обучить LoRA на небольшом наборе авторских фотографий и использовать её для создания новых изображений в близкой визуальной эстетикеЭксперимент показал, что модель может воспроизводить отдельные характеристики стиля: приглушённую палитру, зерно, текстуру сканированной печати и атмосферу независимого fashion-журнала. При этом композиция, анатомия и точность деталей не всегда получаются предсказуемыми, поэтому результаты требуют отбора.Для меня было важно не просто получить красивые изображения, а проверить, насколько узнаваемая визуальная эстетика может переноситься в генеративную модель и трансформироваться в новые работы
Использование ИИ
В проекте использовались генеративная модель Stable Diffusion 1.5, обучение LoRA через Hugging Face Diffusers и генерация изображений в Google Colab. Исходные фотографии были авторскими, а новые изображения созданы нейросетью на основе обученного стиля
Подготовка датасета, настройка параметров, формирование промптов и отбор результатов выполнялись в рамках работы над проектом