Анализ зависимости уровня лингвистически-специфичных галлюцинаций LLM от соотношения мультиязычных данных
Основная суть проекта
В этом проекте мы рассмотрим галлюцинации LLM на разных языках в зависимости от соотношения мультиязычных данных при обучении модели, а также от специфичности обсуждаемой информации для языка генерации
Суть в том, чтобы оценить уровень галлюцинаций для каждого языка на данных, специфичных для этого языка.
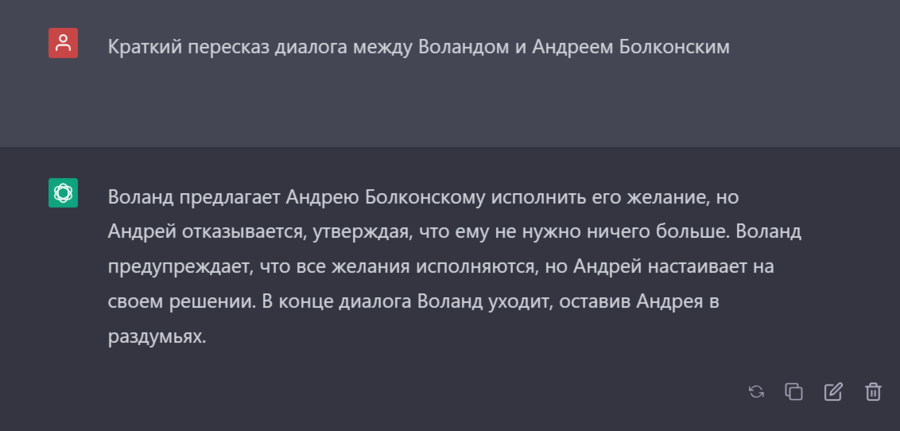
Различные LLM укомплектованы данными на разных языках в разном соотношении. Обычно в большой языковой модели преобладает один язык, являющийся основным. Это нужно чтобы модель могла успешно производить генерализацию знаний на одном языке средствами другого языка.
Однако, у такого подхода есть свои минусы. И один из них — это то, что знания генерализируются не идеально.
В частности, было замечено, что большие языковые модели испытывают сложности с ответами на литературные вопросы…
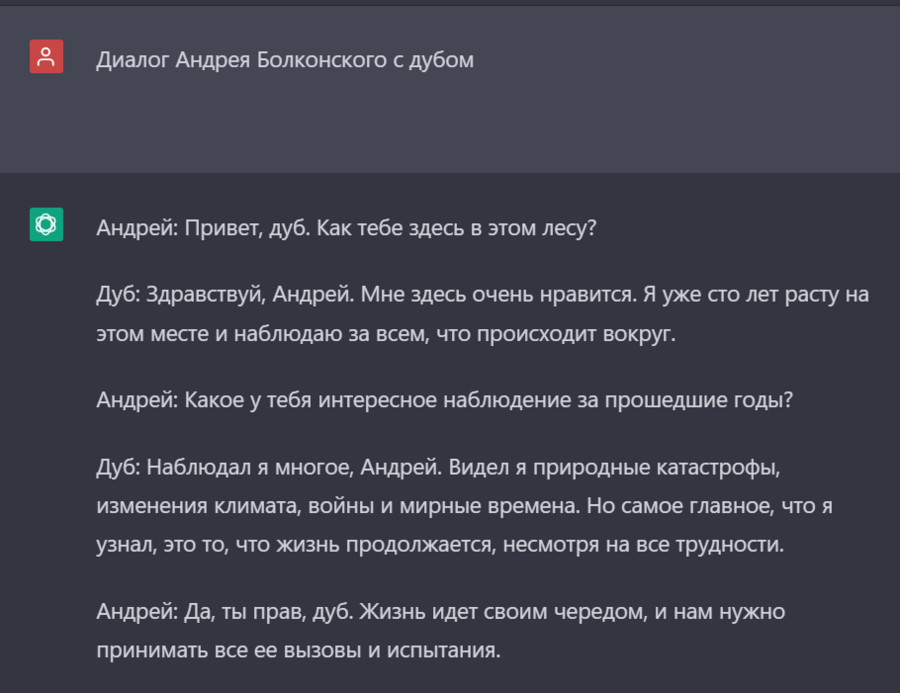
Но помимо запросов, заведомо нелогичных, существуют совершенно нормальные вопросы, на которые модели с трудом отвечают.
Это может касаться не только литературных произведений, но и в целом культурно-обусловленных знаний, которые могут содержаться в данных на одном языке, но отсутствовать в другом.
Галлюцинации, которые возникают в результате такой асимметрии, как и в целом способность отвечать на вопросы, содержащие культурно-специфичные знания, это фокус исследования нашей команды в рамках практики.
Фокус проекта
Цель исследования — оценить при помощи методов NLP степень галлюцинированности LLM при работе с данными, специфичными для конкретного языка.
Предполагаемый метод оценки: сопоставление правильных онтологических данных с неправильными (оценка правильности знания в соотношении верно — не верно).
Предполагается, что в рамках нашего исследования мы рассмотрим и сравним работу LLM, отобранных по принципу их мультиязычности (способности понимать вопросы на различных языках и отвечать на них).
Конкретно моя часть работы будет заключаться в оценке галлюцинаций моделей. Мы предполагаем, что чем больше языков присутствует в модели, тем более сильными будут галлюцинации. Мы также предполагаем, что дело может быть в «культурно-языковой дистанции» между данными, загруженными в языковую модель на разных языках
Основные сложности, с которыми можно столкнуться в рамках моего исследования: — Классификация верных и неверных ответов LLM по отношению к индивидуальным знаниям — Количественная оценка галлюцинаций модели — Разработка универсального пайплайна для разных оцениваемых моделей
Основные задачи: - Сбор данных о знаниях, специфичных для языка/культуры - Разработка пайплайна для работы с оцениваемыми LLM - Оценка степени «галлюцинированности» LLM - Анализ количественных оценок и выводы